Strata 是前段时间关注到的一个端侧的推理框架,在单卡上跑起来 100 多 B 的 Qwen 3.8 Flash Next 模型能够跑出来几十上百 tok/s,能正儿八经跑起来一些 agent 任务,这放一年前是完全没法想象的。
平时工作虽然跟大模型 Infra 有关,但是对推理框架直接经手的不多。就想使用 rust 复现一下 Strata 找找手感,家里的游戏电脑上也比较容易调试。有一说一,搞推理主要的门槛还是机器环境太贵,现在有证明上百 B 这个 size 的模型能用单卡带起来,也是一个了解这部分工作的上手的好路径。
折腾了两个多星期之后勉强能够在自己的机器上和 Strata 跑的性能差不多了。代码仓库在:https://github.com/flaneur2020/naiwa-rs
在本地跑的是 Qwen 3.8 Flash Next 的 Coder 变种,它砍了一半的专家参数,所以总共在七八十 B 左右。性能跑起来大约 Prefill 在 1000 tok/s 左右,Decode 的 TPOT 在 36.8 ms 左右也就是 27.2 tok/s 左右,单纯看生成速度还是很够用的。
硬件是 RTX 4070 12GiB 显存,AMD Ryzen 3600,64GiB DDR4 内存。在调试时候发现这个配置对 Local LLM 并不是很理想,如果 CPU 核心更多、有 AVX512、是 DDR5,肯定能跑到更高。
因为预算问题,手里能用到的模型主要是 DeepSeek V4.1 Flash 和 GPT-6.1-Sol,如果氪 Claude 系的模型我猜应该不至于折腾这么久,不过折腾就在过程。用便宜点儿的模型,仍能留有一部分遇到瓶颈、克服困难的乐趣。。。
这年头单纯记录技术已经没有太大意义了,这篇 blog 就记录一下自己在这个 vibe coding 过程里的感受,全文纯手打没有 agent 成分。
Qwen 3.8 Flash Next 模型与 Strata
Qwen3.8 Flash Next 模型是一个非常稀疏的模型,总共 125B 的模型本体,大部分都是专家参数,其中激活参数只有 6B,512 个专家每层只激活 10 个专家。在模型本体之外,还有 51B 的 Ngram embedding 参数。这样总共就接近于 170B 左右。
总共也小 170B,单靠量化的功劳仍是不够在消费硬件上跑起来的。不过这个模型有两个好处:
- 是真的稀疏,专家参数激活的少;
- Ngram 参数量虽然不小,但是不用 load 到内存,每 token 只需要查一次 SSD 即可;
Strata 的思路就是在专家调度上做一些功夫,让显存中只存放相关的、活跃的专家,这样理论上每层 10 个专家,每个专家只有四五兆,即使只有 12GiB 的消费显卡,在显存上也能放得下。不过 GPU 中的专家会有一定的 cache 和预测的性质,如果 cache miss、预测失败,则直接在 CPU 上跑这几个 miss 的专家,CPU 上跑两三 B 的激活也确实跑的过来。这里比较精细的地方就是需要做到 CPU 计算和 GPU 计算两者的 overlap。
Fork mistral.rs
mistral.rs 中已经有现成的 Qwen 3.8 Flash Next 的实现。所以在我们的仓库中,就直接引用 mistral.rs 的 crate 组装起来一个 server,把除了 Qwen 3.8 Flash Next 之外的其他模型都关掉来减少一些上下文的需要。
到实现 Expert 的调度这里,就需要做一些 fork,能够允许我们将调度 Expert 的逻辑放在我们自己的仓库中。
大概是插类似这么一段 trait 进去:
+/// Routed experts of one MoE block.
+pub trait RoutedExperts: Send + Sync {
+    /// `xs: [batch, seq, hidden]` on the layer device; `topk_weights` / `topk_ids`:
+    /// `[tokens, top_k]` from the model's router. Returns `[tokens, hidden]` on the layer device.
+    fn forward(&self, xs: &Tensor, topk_weights: Tensor, topk_ids: &Tensor) -> Result<Tensor>;
+}
+
+/// Supplies routed experts for MoE blocks at load time.
+pub trait RoutedExpertsProvider: Send + Sync {
+    /// Return `Some` to own this block's routed experts, or `None` to let the model load them.
+    fn build(&self, ctx: ExpertLoadContext<'_>) -> Result<Option<Arc<dyn RoutedExperts>>>;
+}
看 Agent 直接弄了一个全局变量的 registry 来做注入,野是野了一些,但是毫无疑问这样改的切面小。这里的 fork 就不准备回上游,所以就怎么切面小怎么来就完事了。
除了 Expert 的切面,另一个需要在 fork 里加的就是对 Q2_0 和各种 i-Quant 的支持,比如 IQ4_XS、IQ4_NL、IQ3_XXS、IQ2_S、IQ3_S 这些。Strata 的量化会对不同的层做不同的量化格式。没有这些格式的支持,不说跑推理,还在 load Model 时就有报错。
对接这些量化格式是一个力气活,需要把 CPU 和 CUDA 的算子都写出来,但是这个工作好像对智力要求不需要特别高,直接用 ds v4.1 flash 写了一下午就都刷出来了。
Prefill
对于 Prefill 和 Decode 两个阶段,对 Expert 权重的访问 pattern 有比较大的差异。
在 Prefill 阶段,几乎每个 expert 都会被踩到,裁剪 Expert 意义不大,每层几乎需要踩到所有的 Expert。
不过体感下来 Prefill 阶段跑高性能是反而比较简单的,只要做到计算当前层时,overlap 装载下一层的所有专家到 GPU 显存就可以。
装载下一层的所有专家参数需要传输的时间并不算少。不过装载 Prefill 阶段有一个好处是我们可以通过攒更大的批,来让计算密度重叠到传输需要的时间上面,即使走完整个的所有层到 3 秒这个级别,攒到 3000 一个批,Prefill 的整体性能也是 1k tok/s。
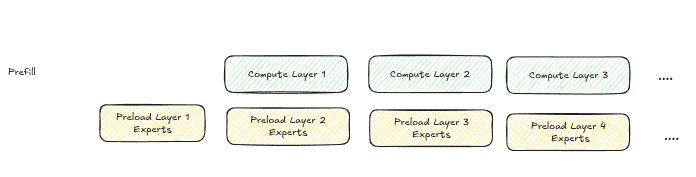
不过在这个重叠之中,第一层的计算还是有一个阻塞等待。而且显存里需要空两层的 Expert 参数才行。
这里可以考虑的是增加 overlap 的深度,大约思路就是将一层拆成两半甚至 4 半,在这个 overlap 流水线里,一次算一部分专家的参数,这样每个阶段的传输量和计算量都减半,也可以把深度堆的更深,比如我们可以提前预读后面两个阶段所需的专家权重:
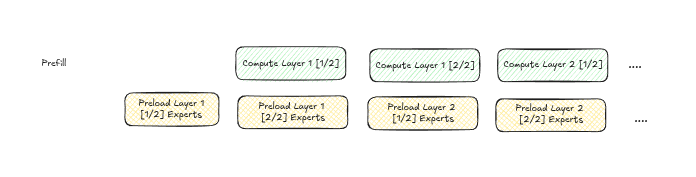
这个思路一眼望过去还挺 make sense,不过在 benchmark 里好像没有明显提升,我猜可能原因还是批次大了之后,计算密集任务的耗时大过了内存搬运,拆小的效益就不明显了,反过来增加了些发射的开销。
Decode
Decode 方面花的时间就比 Prefill 多了好多,意外的很多细节。
Decode 阶段的思路也很直接,就是在 Experts Router 得出专家列表之后,判定一下,如果这块 Expert 在 GPU 的 Expert Cache 中,则优先用 GPU 跑,否则用 CPU 跑。
这个是基本的思路,不过在迭代中也额外加了一个逻辑是,对于 GPU 的 Expert Cache 中没有的部分 Expert,也通过 PCIe 传输给 GPU 计算一下,毕竟 GPU 在等待 CPU 结果的期间,算力还比较空闲。
除此之外,还要不要加一个 readahead 机制,提前预装一把下一层的 Expert。最后就几乎成了这样:
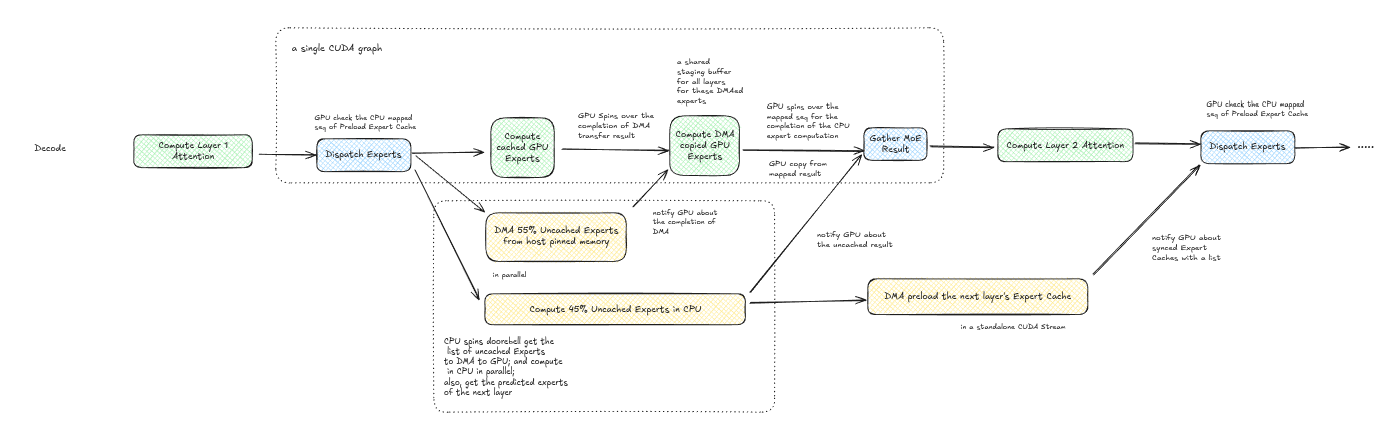
在 Expert Router 分流之后,就有了三个路径:
- GPU 计算位于显存内的专家;
- 对于 Miss 的专家,拷贝一小部分到 GPU 显存,再在 GPU 里计算;
- 剩下的专家,在 CPU 里原地计算后,返回给 GPU;
这个流程意外的吃同步。看 Strata 的做法是没有用原生的 CUDA 的 stream 来传输,而是做了一个 doorbell 机制,让 GPU 等 CPU 的时候自旋读一块共享内存,CPU 在完成工作时,把结果写回到共享内存里,并改这个共享内存里的一个原子变量来通知 GPU 退出自旋。
Strata 这样做还有一个原因是它将整个 Decode 给录成了一个 CUDA Graph,这样一次 Decode 只需要一次 CUDA 的发射。这样在 CUDA Graph 执行期间,自然也就没有其他的 CUDA 通信,因此使用共享内存的 doorbell 机制不失是一个轻量又实时性高的好办法。
折腾期间我一度也想学习这个完整录制 CUDA Graph 的办法,不过折腾了一个星期发现要搞 CUDA Graph 需要从比较底层的 CUDA 原语上手,代码里但凡有任何一段 candle 的 Tensor 的 .to_vec() 类似的传回 CPU 的写法就没法录制了。折腾最后的结论是 CUDA Graph 要做录制,最好还是第一天设计的时候就考虑在里面,折腾一半再从这个底下加回来就费劲了,侵入性太深,所以最后还是放弃了这部分。不过 doorbell 机制还是借鉴了来,因为看起来这样 busy polling 应该有助于降延迟。
不过这套东西实现出来之后,一直距离 Strata 的性能差一截,TPOT 总是差 2~3ms。
这里就(因为图省钱而)经历了很长的一个挫败期。使用 Deepseek V4.1 Flash 在做这里的优化的时候,经常走到了这样的循环:
- ds v4.1 flash 给出来几个假设,几个可行的方向,然后列出来一个表格的 checklist;
- 然后做 checklist 中的可能性最大的一项展开工作;
- 为了做这项工作,需要先解决 A/B/C/D,然后一步一步的做;
- 一步步做玩了之后,评测没有发现收益,然后标记为『死』;
- 然后继续 prompt 让它分析现状,又列出来几个可能方向;
- 循环到又标记为『死』;
- 再 prompt 让它分析时,又提出了之前最开始时的假设;
已知我们这里不想改成 CUDA Graph 了,所以只能在 eager 这里一点点抠性能。如果性能的差距确实来自 CUDA Graph,也就没有办法更进一步了。
走投无路之下找了 GPT 6 Astral,前景一下子清晰了不少。这个过程里发现到比较有用的 prompt 是「请详细归因」而非直接的「做性能优化」。为了做归因,agent 会在代码里插很多埋点分析。有了详细的归因之后,再做优化就简单了许多,这时干活找 GPT-6.1-Sol 就能够便宜很多。
最后做了大约这几项优化:
- 在 DMA 传输 miss 的 Expert 到 GPU 之前先发起 CPU 计算 Expert 的任务,提升了 0.9~1ms 左右;
- lookahead-swaps 从 2 减少到 1,减少 Expert Cache 的抖动,好像因为多提升 Expert 到 GPU 也不会提高更多的命中率,优化 0.9ms 左右;
- 把 Expert Route 改到纯 GPU 计算不让它经过 CPU(按说本来也不该经过 CPU,但是之前就 vibe 成这样了),优化 1.5ms 左右;
- CPU Expert 计算从 rayon 默认的线程池改到 busy polling 的 spin 任务的线程池,加上 pin 住线程到物理核心,优化 1~2ms 左右;
这几波优化后,就终于和 Strata 在这个机器上的速度跑平了(36.8 ms 左右)。早用 SOTA 模型的话按说可以更早解决这个优化问题,但是没有这些 round trip,我想对这块问题的深浅和 SOTA 模型的能力的理解就还是会脱节一些。
思考
在 Decode 的流程里,人脑很容易画出来一个很 make sense 的流转图,但是微观在执行上很容易存有宏观上的这个流转图比较难于展现的细节。这时除了细致的归因和 benchmarking 便没有其余的办法。而归因和 benchmarking 又是一个很苦逼的 trial and error 的活,如果没有强力的 Agent,真的很难想象靠人肉去磕这些得花多少时间!
不过另一面看,即使是强力的 AI,也未必全靠直觉一次性出来最优的代码。它也要先写出来能跑的,再自己做性能分析的 harness、做归因、做 benchmarking。也同样需要经历 trial and error 的一个过程。所以,就整个过程而言,也未必是 one prompt 便许愿成功,客观来讲观察这个实验的过程也仍有少量乐趣残存。我想后面如果遇到感兴趣的项目,仍可以按类似的方法去复现实验来 see how it goes。